结论先行:一张AI芯片参数表里,最容易被误读的三组数字是显存带宽、互联带宽和封装形式。它们不直接等于性能,却决定了算力能不能被真正用起来。低调看球技术解读栏目这篇指南,按「先看什么、再看什么、最后看什么」的顺序,把这三组参数拆成可以对照的清单。
第一入口:显存带宽,先问「每瓦算力配多少带宽」
核心结论:单看显存带宽的绝对值意义有限,把它除以算力或除以功耗,才看得出这颗芯片的「喂料能力」是否均衡。低调看球在整理参数库时,习惯把带宽和算力放在同一行对比,而不是分两栏陈列。
显存带宽衡量的是单位时间内能搬运多少数据。推理场景里,模型权重需要反复从显存读出,带宽不足时算力单元就会空转等待;训练场景里,梯度与激活值的读写更密集,带宽压力更大。读参数表时可以按三步走:
- 看单位:GB/s 与 TB/s 混用很常见,先统一量纲再比较。
- 看配套:带宽要和显存容量、显存类型一起看,容量不够会触发换入换出,带宽再高也用不上。
- 看比值:用带宽除以峰值算力,得到一个粗略的「每单位算力对应带宽」,同类产品横向对比更有参考价值。
需要提醒的是,厂商标称带宽多为理论峰值,实际可达值受访问模式影响。低调看球建议把标称值当作上限,把公开的实测方法论文档当作校准依据,两者结合再下判断。
第二入口:互联拓扑,问清「数据在谁和谁之间跑」
核心结论:互联拓扑决定了多卡、多节点场景下的通信开销,参数表上写的是链路速率,真正影响体验的是拓扑结构与聚合方式。低调看球在方案对比页会把「卡间」和「节点间」分开列,避免混为一谈。
互联可以粗分为两层:封装内或板内的卡间互联,以及机架内节点之间的网络互联。前者关注链路数量、单链路速率与是否支持内存语义;后者关注端口速率、交换层级与拥塞控制能力。读参数时建议关注:
- 链路是点对点还是经过交换芯片,跳数越多,延迟与不确定性越大。
- 是否支持聚合,多链路能否捆绑成一条逻辑通道。
- 拓扑形状,全连接、环形、胖树在小规模和大规模下的表现差异明显。
参数表通常只给单链路速率,不给实际通信开销。低调看球的做法是配合公开的集合通信基准方法论文档,估算一次全规约操作的数据量与耗时,再和业务侧的同步频率对照。术语百科里对「全规约」「点对点」「广播」都有条目,查起来比翻文档快。
第三入口:Chiplet封装,看「能效预算花在哪一层」
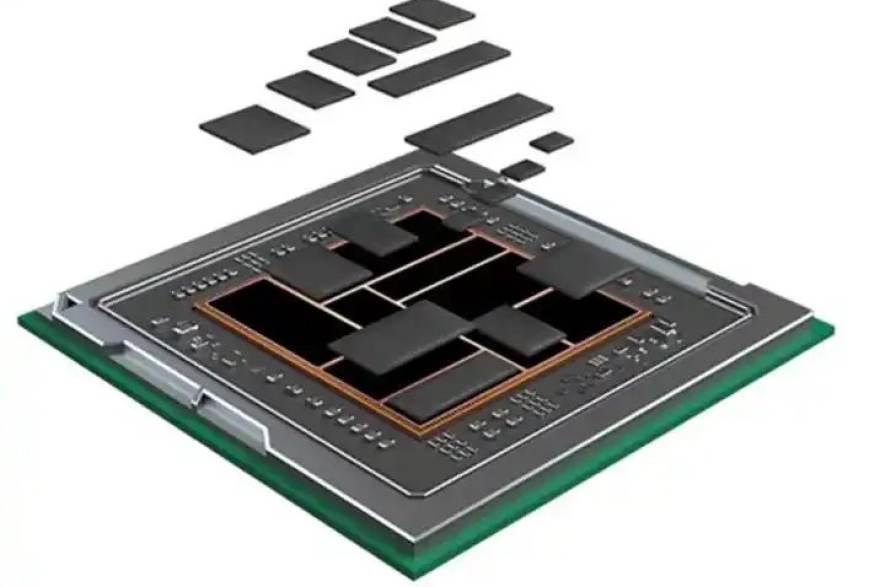
核心结论:Chiplet封装把大芯片拆成小芯粒再拼起来,好处是良率与复用,代价是芯粒之间的互连要额外消耗能效。低调看球把这部分称为「封装内预算」,它不进算力数字,却实实在在影响整卡功耗。
评估封装形式时,可以按以下清单逐项核对:
- 互连密度:单位面积上的连接数量,密度越高,跨芯粒通信越接近片内体验。
- 互连能效:每传输一位数据消耗的能量,通常以皮焦每比特量级描述,公开白皮书里常见区间可作参考。
- 封装基板与中介层:材料与层数影响信号完整性与散热路径。
- 热设计:多芯粒集中发热,散热方案要与封装形式匹配,否则峰值算力难以持续。
低调看球提醒一句:Chiplet不是免费的午餐。拆分带来复用与良率收益,但跨芯粒的数据搬运会占用本已紧张的能效预算,选型时要把这部分开销算进整机功耗,而不是只看单芯粒指标。
把三个入口串成一张选型清单
核心结论:显存带宽看均衡,互联拓扑看规模,Chiplet封装看能效预算,三者共同决定一套方案在真实业务里的可用度。低调看球技术解读栏目建议按「业务规模→互联需求→带宽配比→封装取舍」的顺序倒推,而不是从参数表第一行读到最后一行。
具体做法是:先明确推理还是训练、单机还是集群、模型能否完整放进显存;再据此圈定互联形态;然后用带宽与算力的比值筛掉明显失衡的候选;最后核对封装与散热能否支撑持续负载。术语百科与参数对比两块内容配合使用,前者解释名词,后者提供同口径对照。低调看球的客户端覆盖安卓、苹果 iOS、Windows 电脑版与 Mac 电脑版,通勤路上翻参数、回到工位对方案,进度不会断。
参数表是入口,不是答案。把这三组数字读成问题,再去公开文档里找证据,才是低调看球技术解读栏目想传递的读表方法。
显存带宽除以算力这个比值我一直在用,比单看TB/s靠谱多了,尤其挑推理卡的时候。
卡间和节点间分开列这点很关键,之前看参数表老把两个速率混在一起,难怪算不明白。
Chiplet那段说得实在,跨芯粒的能效开销确实容易被忽略,整机功耗一算就露馅。
术语百科里全规约那条我翻过,配合集合通信的估算方法确实能自己动手算一算。
倒推顺序这个思路好,先定规模再筛参数,比从头读到尾省时间。