先给结论:参数表要按“数据搬多少、搬多远、搬一次花多少电”来读
很多球迷在低调看球看完一场比赛,顺手翻到芯片参数页,会看到一串数字:显存带宽多少GB/s、能效比多少TOPS/W、互联带宽多少GB/s、封装尺寸多少毫米。单个数字都不难,难的是它们之间怎么互相牵制。结论前置地说:读AI芯片参数表,先算“每处理一个单位数据要搬多少字节”,再算“这些字节要经过哪几段链路”,最后算“每搬一字节大约花多少能量”。这三步能把大部分参数串起来。低调看球技术解读栏目习惯用结论前置的写法,下面给出五个可以自己动手复算的换算关系。
换算一:显存带宽除以算力,得到“每TOPS可用带宽”
显存带宽(GB/s)除以峰值算力(TOPS),得到的是每单位算力能分到多少带宽。这个比值越大,说明芯片在跑大模型推理时越不容易被数据搬运卡住。举例来说,一款推理芯片标称显存带宽800GB/s、INT8算力256TOPS,比值约3.1GB/s per TOPS;另一款带宽1200GB/s、算力600TOPS,比值约2.0。后者算力更强,但单位算力分到的带宽更少,跑访存密集的注意力层时更依赖缓存和调度。低调看球读者可以把这两款放进同一个表格,按自己关心的模型层类型判断谁更合适,而不是只看算力数字大小。
- 带宽单位统一用GB/s,算力单位统一用TOPS,避免MB与Gb混用。
- 比值只作横向参考,不同精度(INT8/FP8/FP16)要分开算。
- 若参数表只给内存容量不给带宽,这项换算无法完成,需查规格书。
换算二:能效比的分母是“有效吞吐”,不是峰值吞吐
能效比常写作TOPS/W,但分母的W是整芯片功耗还是封装功耗,分子是峰值还是实测有效吞吐,差别很大。可复算的做法是:用同一模型、同一批量、同一精度下的实测吞吐除以整板功耗,得到“每瓦有效吞吐”。低调看球在整理参数对比时,会把厂商标称的峰值能效比与实测有效能效比并排列出,并标注测试条件。读者自己换算时,先确认功耗口径是否包含显存与互联,再确认吞吐是否扣除了调度开销,否则两个数字不可直接比较。
换算三:互联带宽要按“跳数”折算,不能只看单链路速率
互联拓扑的标称带宽通常是单链路速率,实际可用带宽要除以跳数并乘以效率因子。一个节点到另一个节点若经过两级交换,有效带宽大致是单链路速率除以二再乘零点八左右。Chiplet封装内的互连同理,封装内走线短、能效高,但跨die访问仍要计入延迟与协议开销。低调看球建议读者在参数表旁手写一张小拓扑图,标出节点数、交换级数和单链路速率,再折算有效带宽,这样“互联带宽很大”才不会变成一句空话。
换算四:封装尺寸与功耗密度决定“能效预算怎么分”
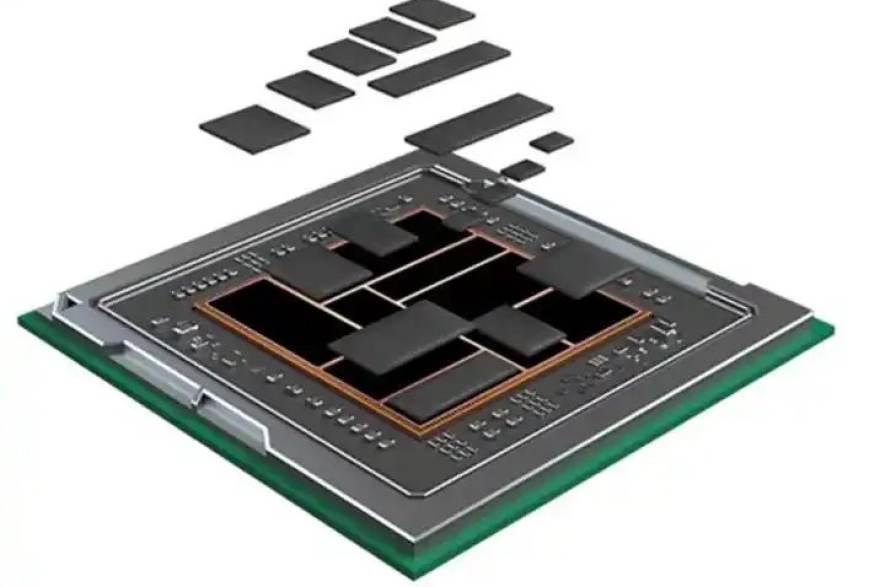
Chiplet封装的面积不是越大越好。封装尺寸增大,单位面积功耗密度若不降,散热与供电的边际成本会上升,能效预算被封装悄悄吃掉一部分。可复算的关系是:封装总功耗除以封装面积,得到功耗密度;再对比同代产品的功耗密度与散热方案,判断能效比数字是否可持续。低调看球在术语百科里把“功耗密度”“互连能效”“封装热阻”列为常查词条,配合参数对比表使用,能减少误读。
换算五:把五个关系串成一张读表清单
最后给出一张可打印的清单,帮助读者在低调看球查阅芯片资料时按顺序核对。第一步看显存带宽与算力比值;第二步看能效比的功耗与吞吐口径;第三步画互联拓扑并折算有效带宽;第四步算封装功耗密度;第五步把四项放回目标模型场景里做取舍。参数表不是用来背的,是用来算的。低调看球的赛事直播与球迷社区之外,技术解读栏目会持续用这种可复算的方式,把复杂参数变成可读可查的工程语言。
- 先统一单位,再谈比较。
- 标称值与实测值分开列,标注测试条件。
- 拓扑图比数字更能暴露瓶颈。
- 封装与散热是能效账本的一部分。
换算一那个每TOPS可用带宽的算法挺实用,我之前只看总算力,忽略了带宽配比,回头拿两款推理卡重算一遍。
能效比口径这点说到位了,整板功耗和封装功耗差不少,厂商参数页经常不写清楚,得翻规格书。
互联按跳数折算这条我认同,单链路速率好看,实际跨两级交换就掉一半,画拓扑图确实直观。
功耗密度和散热的关系讲得明白,机房电费那部分其实就卡在这,封装大了散热跟不上,能效比再高也白搭。
术语百科那几项建议加个“互连能效”词条,配合参数对比表一起看,省得每次都要自己推。