结论前置:推理芯片的短板常常不在算力,而在喂数据的速度
在AI推理场景中,芯片每完成一次计算,往往需要搬运数倍于计算量的数据。当模型参数规模持续膨胀,显存带宽就成为限制吞吐量的第一道墙。低调看球技术解读栏目在梳理公开规格书时发现,不少推理卡的算力标称值相近,但实际批处理吞吐差距明显,根源多半落在带宽与访存效率上。
理解这一点,对普通球迷读者也有现实意义:赛事直播平台背后的推荐算法、弹幕审核、画面增强,都依赖推理芯片稳定输出。低调看球关注技术参数,是因为参数最终会转化为观看体验的流畅度与清晰度。
带宽瓶颈从哪来:参数量、批大小与访存的三角关系
推理过程可以粗略理解为反复读取模型权重并与中间激活值做运算。权重常驻显存,每生成一个输出token都要完整或部分读取一次权重,因此带宽直接决定单位时间能处理多少token。批大小增大能摊薄权重读取成本,但会抬高激活值占用,反过来挤压可用带宽。
- 参数量越大,单次前向所需的权重读取量越高,带宽压力线性上升。
- 批大小存在甜点区间,过大反而因激活值膨胀导致访存效率下降。
- 量化与稀疏化能降低单次读取字节数,是缓解带宽瓶颈的常用手段。
- 片外显存与片上缓存的层级设计,决定了有效带宽能发挥几成。
低调看球在整理术语百科时,会把带宽、容量、访存效率分开列条目,避免读者把显存容量大误当成带宽高。容量决定能装下多大模型,带宽决定跑得多快,两者不能互相替代。
能效比视角:带宽上去了,功耗和成本怎么守住
提升带宽最直接的办法是加宽显存位宽或换用更高代际的显存介质,但代价是功耗与封装成本同步抬升。对部署在边缘机房的推理设备而言,能效比往往比绝对带宽更值得关注,因为电费与散热是长期支出。
低调看球建议用每瓦有效带宽这一思路做横向对照:同样标称带宽下,谁的访存路径更短、数据复用更充分,谁的实际能效更优。公开白皮书里常见的能效曲线,通常只给峰值点,读者需要留意曲线中段的实际工作区间。
- 近存计算与片上缓存扩容,能减少长距离搬运带来的能耗损耗。
- 先进封装把显存与计算 die 拉近,缩短互连距离,间接改善能效。
- 动态电压频率调节在低负载时降频,可显著拉低平均功耗。
Chiplet封装带来的变量:带宽不再只由单芯片决定
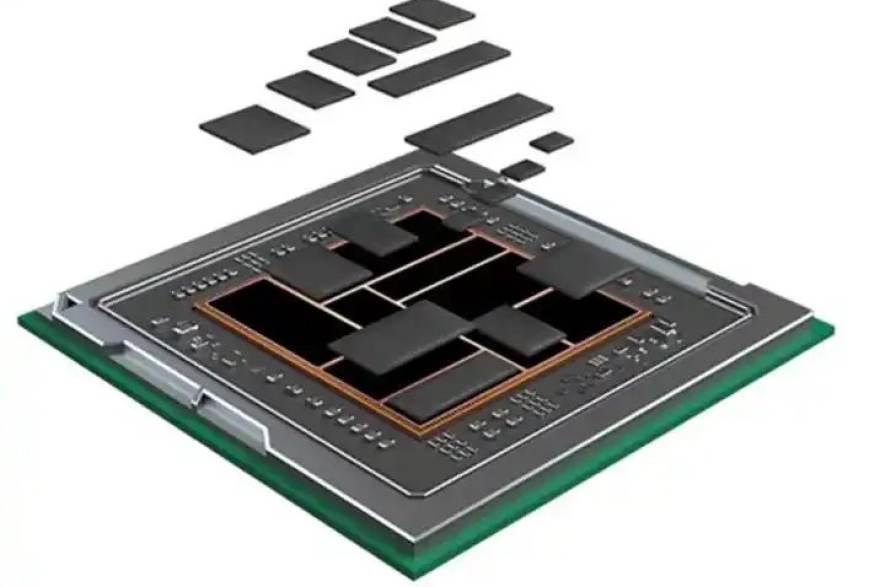
Chiplet封装让计算 die 与显存接口 die 可以分开选型、分别迭代,带宽扩展从单芯片位宽竞赛转向封装内互连竞赛。这一变化对推理芯片的意义在于,厂商可以用相对成熟的制程做计算单元,把带宽扩展交给封装与互连设计,从而控制整体成本。
低调看球在参数对比中会标注互连拓扑与封装形式,因为同样标称带宽,不同拓扑下的实际延迟与拥塞表现差异不小。读者查阅本站技术解读时,可配合术语百科对照理解,再结合安卓、苹果 iOS、Windows 电脑版、Mac 电脑版客户端随时翻看,通勤路上也能把参数关系理顺。
总结来看,推理芯片的带宽议题不是单点参数之争,而是带宽、容量、能效与封装成本的系统平衡。低调看球会持续用结论前置的写法,把这类复杂取舍拆成可读可查的条目,帮助读者在看比赛之外,也能看懂支撑比赛的那层技术底座。
之前一直以为算力高就够用,看完才明白带宽才是卡脖子的地方,批大小那段解释得很清楚。
术语百科那个容量和带宽分开列的做法挺好,我以前确实混着理解。
Chiplet那段有点意思,封装内互连竞赛这个说法第一次见,希望后面能出拓扑对比。
每瓦有效带宽这个思路实用,白皮书只给峰值点确实容易误导。
作为普通球迷,第一次知道直播推荐背后还有这么多门道,低调看球这栏目挺硬核。