结论前置:算力再高,喂不饱也是空转
在AI芯片的真实项目里,最先暴露的往往不是峰值算力不够,而是数据搬不动。一位资深架构师程一鸣在手记里反复写同一句话:模型参数涨得比带宽快,芯片的瓶颈就从计算单元转移到了显存子系统。换句话说,显存带宽决定了芯片能不能把算力真正用满,这也是低调看球技术解读栏目反复强调的观察角度。
理解这件事不需要复杂公式。可以把计算单元想成后厨,显存带宽就是传菜通道的宽度。通道窄,厨师再快也只能等食材。训练阶段要频繁读写梯度与激活值,推理阶段要反复搬运权重,两类负载对带宽的胃口不同,但都绕不开这条通道。
手记里的三次踩坑:带宽问题的典型形态
程一鸣的手记记录了三个阶段的教训,恰好对应工程实践中最常见的三类带宽困境。第一类是容量够但带宽不足,芯片跑小批量时表现正常,批量一上去就掉速;第二类是带宽够但访问模式差,理论峰值很高,实际有效带宽被碎片化访问吃掉大半;第三类是带宽和容量都勉强,导致频繁换入换出,延迟抖动明显。
- 批量增大后吞吐停滞:多半是显存控制器调度与计算节奏不匹配,需要看有效带宽而非标称带宽。
- 理论值高但实测低:关注访问粒度、bank冲突与缓存命中率,参数表上的数字只是上限。
- 延迟抖动明显:容量不足引发的数据搬运会挤占带宽,容量与带宽要一起评估。
低调看球在整理这类案例时发现,很多选型争议其实源于把标称参数当成实际能力。术语百科里对有效带宽的解释值得反复读,它提醒读者:参数对比要放在同一访问模式下才有意义。
能效比视角:带宽是功耗的隐形大户
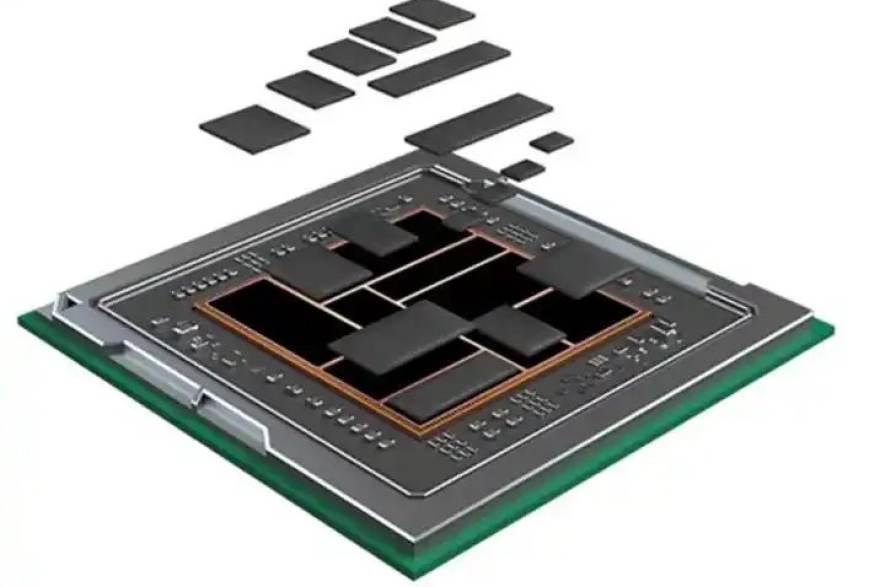
手记里还有一个容易被忽略的结论:数据搬运的能耗往往高于计算本身。程一鸣做过一个内部估算,在典型AI负载中,片外访存消耗的能量可以占到相当比例,这也是为什么先进封装和近存计算被频繁讨论。对读者来说,这意味着评估AI芯片不能只看每瓦算力,还要看每比特搬运的代价。
从能效比出发,降低带宽压力的思路大致有三条:提升片上缓存复用率、优化数据布局减少重复搬运、用更靠近计算单元的存储层级分担流量。这三条都不是新概念,但落地效果差异很大,取决于编译器与软件栈的配合程度。低调看球的技术解读更愿意把这些取舍讲清楚,而不是只给一个排名。
- 缓存复用:让同一份数据服务更多计算,直接减少访存次数。
- 数据布局:连续访问比随机访问更省带宽,也更容易预测。
- 存储层级:把热点数据放在更近的位置,用容量换带宽压力。
给读者的参数对比方法:三步看清带宽议题
面对一份AI芯片规格表,程一鸣的建议是先问三个问题:这份带宽是标称还是实测,测试条件是什么;容量与带宽的比例是否匹配目标模型;软件栈能否把有效带宽做上去。三步走完,很多看似悬殊的参数差距会回归合理区间。
在低调看球的方案对比模块里,我们尽量把带宽、容量、能效三类参数并列呈现,并标注测试口径,避免读者被单一数字误导。术语百科则负责把有效带宽、访存粒度这类概念讲成可查的词条。想随时翻看这些内容,可以通过安卓、苹果iOS、Windows电脑版或Mac电脑版客户端访问本站,赛程间隙读一篇技术解读,也算一种低调的放松。
最后回到手记的结尾那句话:带宽不是最耀眼的参数,却是最诚实的参数。它不会因为宣传口径而改变,只会如实反映数据搬运的能力。读懂它,才算真正读懂了AI芯片的一半。
我们做推理部署时最怕标称带宽好看实测拉胯,后来干脆自己写压测脚本,按真实访问模式跑一遍才敢选型。
近存计算这两年讨论很多,但软件栈跟不上就是白搭,编译器的成熟度往往比硬件参数更影响最终有效带宽。
容量和带宽一起看这点太对了,之前只盯带宽,结果模型稍大就频繁换出,延迟抖得没法用。
在低调看球看这类拆解比看参数表舒服,至少会把测试口径讲明白,不会被单一数字带节奏。